المدونة / كيف تقيس دقة الترميز الطبي الآلي: دقة الرموز واكتمالها والتوجيه حسب الثقة
كيف تقيس دقة الترميز الطبي الآلي: دقة الرموز واكتمالها والتوجيه حسب الثقة
دقة الرموز (Precision) واكتمالها (Recall)، والملاحظات الصحيحة بالكامل، والمتوسط الجزئي والكلي، ومجموعة اختبار عادلة، ولماذا يمكن محاسبة نظام لا يُكمل إلا الملاحظات التي يثق بها بمعيار أعلى.

الخلاصة
- الملاحظة السريرية تحتاج عادةً إلى عدة رموز، ولذلك لا تُقاس «الدقة» بمستوى واحد.
- دقة الرموز (Precision): كم من الرموز التي وضعها النظام صحيح. واكتمال الرموز (Recall): كم من الرموز الصحيحة وجده النظام.
- الملاحظات الصحيحة بالكامل: نسبة الملاحظات التي طابق فيها كل رمز الإجابة المراجَعة. وهي أشد المقاييس، وأقربها إلى ما يعيشه المرمّز.
- الاختبار العادل يستخدم ملاحظات لم تدخل في التدريب، روجعت مرتين، من تخصصات متعددة، وعلى قائمة الرموز التي تشترطها الجهة التنظيمية لمطالباتك.
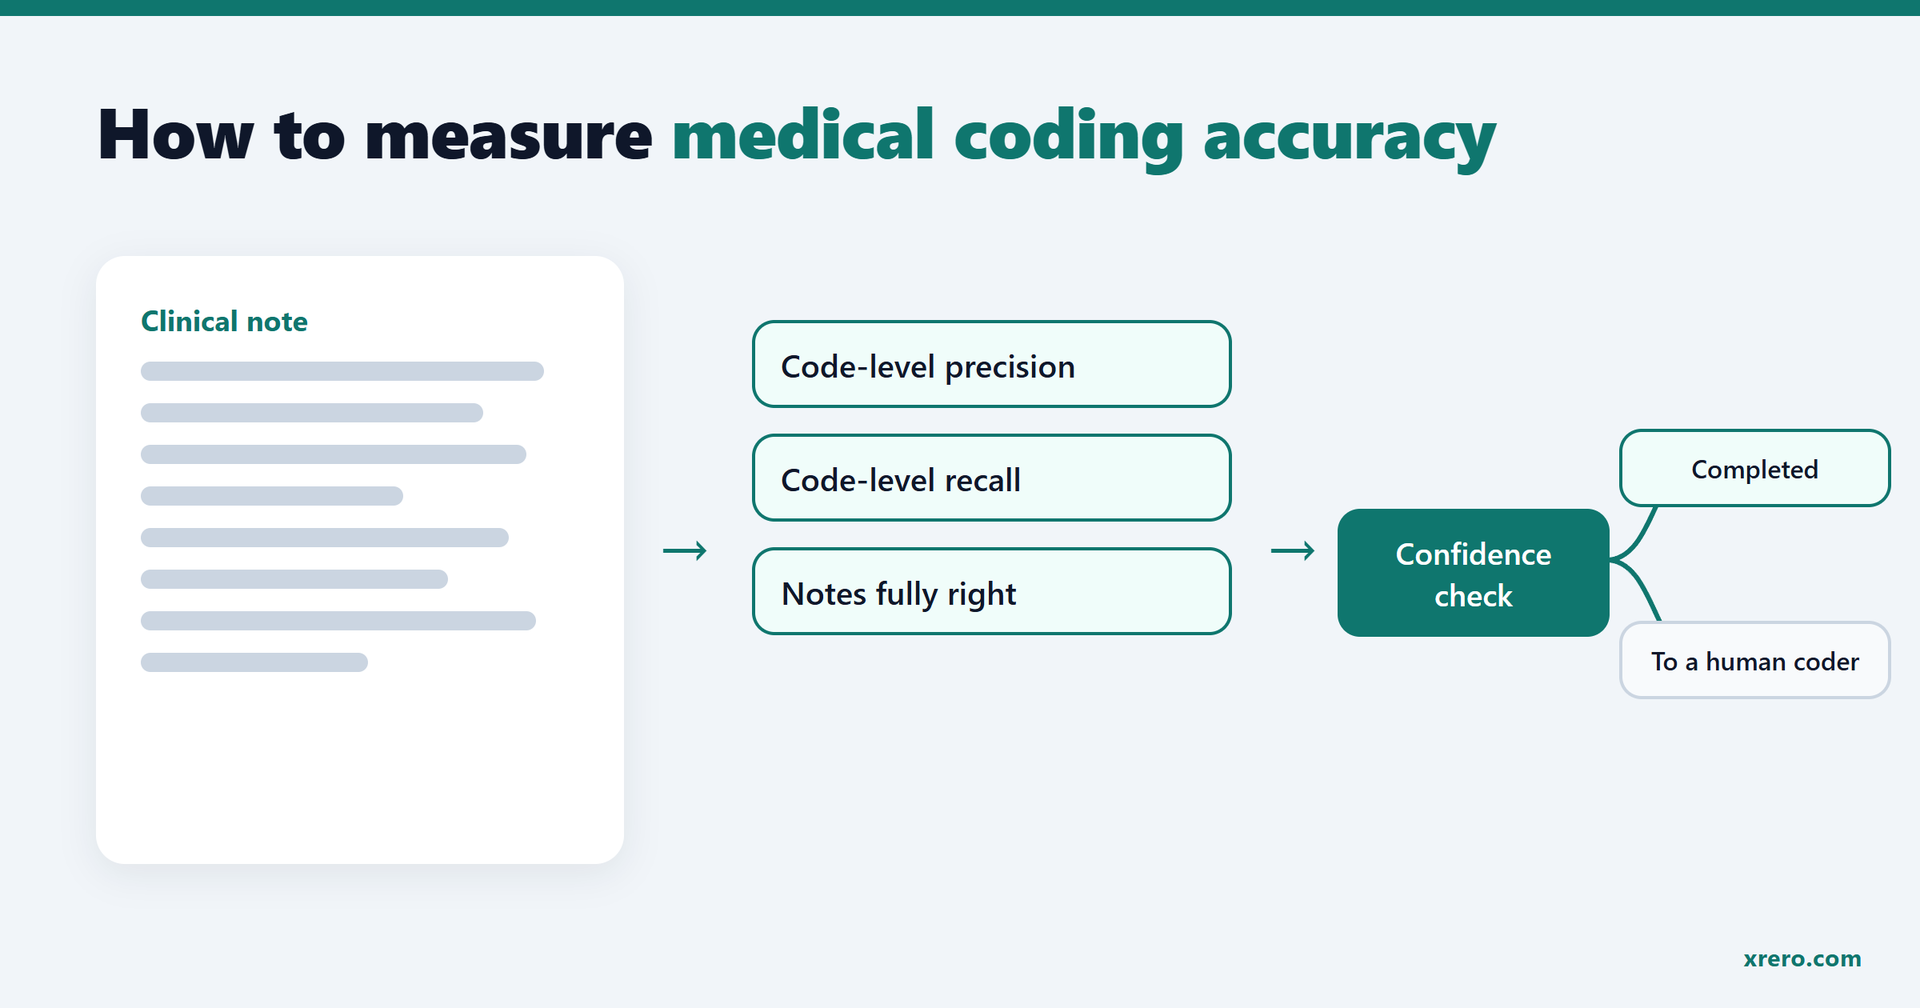
- التوجيه حسب الثقة يسمح للنظام بأن يُكمل الملاحظات التي يثق بها فقط ويرسل البقية إلى مرمّز بشري. اقرأ دائمًا دقته على تلك الملاحظات بجانب نسبة ما أكمله منها.
لقياس دقة الترميز الطبي الآلي، قِسها على ثلاثة مستويات: دقة الرموز (كم من الرموز الموضوعة صحيح)، واكتمال الرموز (كم من الرموز الصحيحة وُجد)، والملاحظات الصحيحة بالكامل (كل رموز الملاحظة صحيحة). ثم افحص التغطية: أي الملاحظات يُكملها النظام وحده، وأيها يذهب إلى مرمّز بشري.
ماذا تعني «الدقة» في نظام ترميز طبي آلي؟
تعني مدى تطابق الرموز التي يضعها النظام مع الرموز التي كان سيضعها مرمّز بشري متأنٍّ للملاحظة نفسها. والصعوبة أن الملاحظة نادرًا ما تحمل رمزًا واحدًا.
ملاحظة زيارة رعاية منزلية قد تحمل تشخيصًا رئيسيًا وعدة حالات ثانوية ورمزًا للتاريخ المرضي ورمزًا للحالة. وملاحظة الطوارئ قد تحتاج إلى رمز الإصابة ورمز السبب الخارجي ورمز مكان الحدوث. وبلغة تعلّم الآلة هذه مهمة متعددة التسميات: لكل ملاحظة مجموعة من الرموز الصحيحة، ويقترح النظام مجموعته الخاصة.
والمقارنة بين مجموعتين قد تخطئ بثلاث طرق مختلفة: أن يضيف النظام رمزًا لا تدعمه الملاحظة، أو أن يترك رمزًا تدعمه، أو أن يختار رمزًا مجاورًا من العائلة الصحيحة لكن بمستوى تفصيل خاطئ. ورقم «دقة» واحد يخلط هذه الأخطاء معًا. ولهذا يعرض الباحثون في الترميز الآلي عدة مقاييس جنبًا إلى جنب؛ فدراسة Code Like Humans (Motzfeldt وEdin وآخرون، EMNLP Findings 2025) مثلًا تعرض مقياس F1 الجزئي والكلي ونسبة التطابق التام والاكتمال لكل جزء من نظامها.
أما من يشتري النظام فتجيبه ثلاثة مقاييس عن أسئلته العملية: هل الرموز التي يعطيني إياها صحيحة؟ هل يفوّت رموزًا؟ وكم ملاحظة أستطيع قبولها دون أن ألمسها؟
كيف تُحسب دقة الرموز واكتمالها؟
احسب الرموز لا الملاحظات. الدقة هي الرموز الصحيحة مقسومة على كل ما وضعه النظام من رموز. والاكتمال هو الرموز الصحيحة مقسومة على كل الرموز التي كان يجب أن تحملها الملاحظة.
هذه هي التعريفات المعتادة في تعلّم الآلة؛ إذ يعرّف مقرر تعلّم الآلة من Google (Google for Developers) الدقة بأنها TP / (TP + FP) والاكتمال بأنه TP / (TP + FN). وفي لغة الترميز:
- إيجابي صحيح (TP): رمز وضعه النظام وهو موجود في الإجابة المراجَعة.
- إيجابي خاطئ (FP): رمز وضعه النظام وليس في الإجابة المراجَعة، مثل تشخيص لا تدعمه الملاحظة، أو في ترميز العيادات الخارجية والرعاية المنزلية تشخيص غير مؤكد «للاستبعاد»، إذ تنص إرشادات ICD-10-CM للعيادات الخارجية على عدم ترميزه.
- سلبي خاطئ (FN): رمز في الإجابة المراجَعة لم يضعه النظام، مثل حالة ثانوية فاتته.
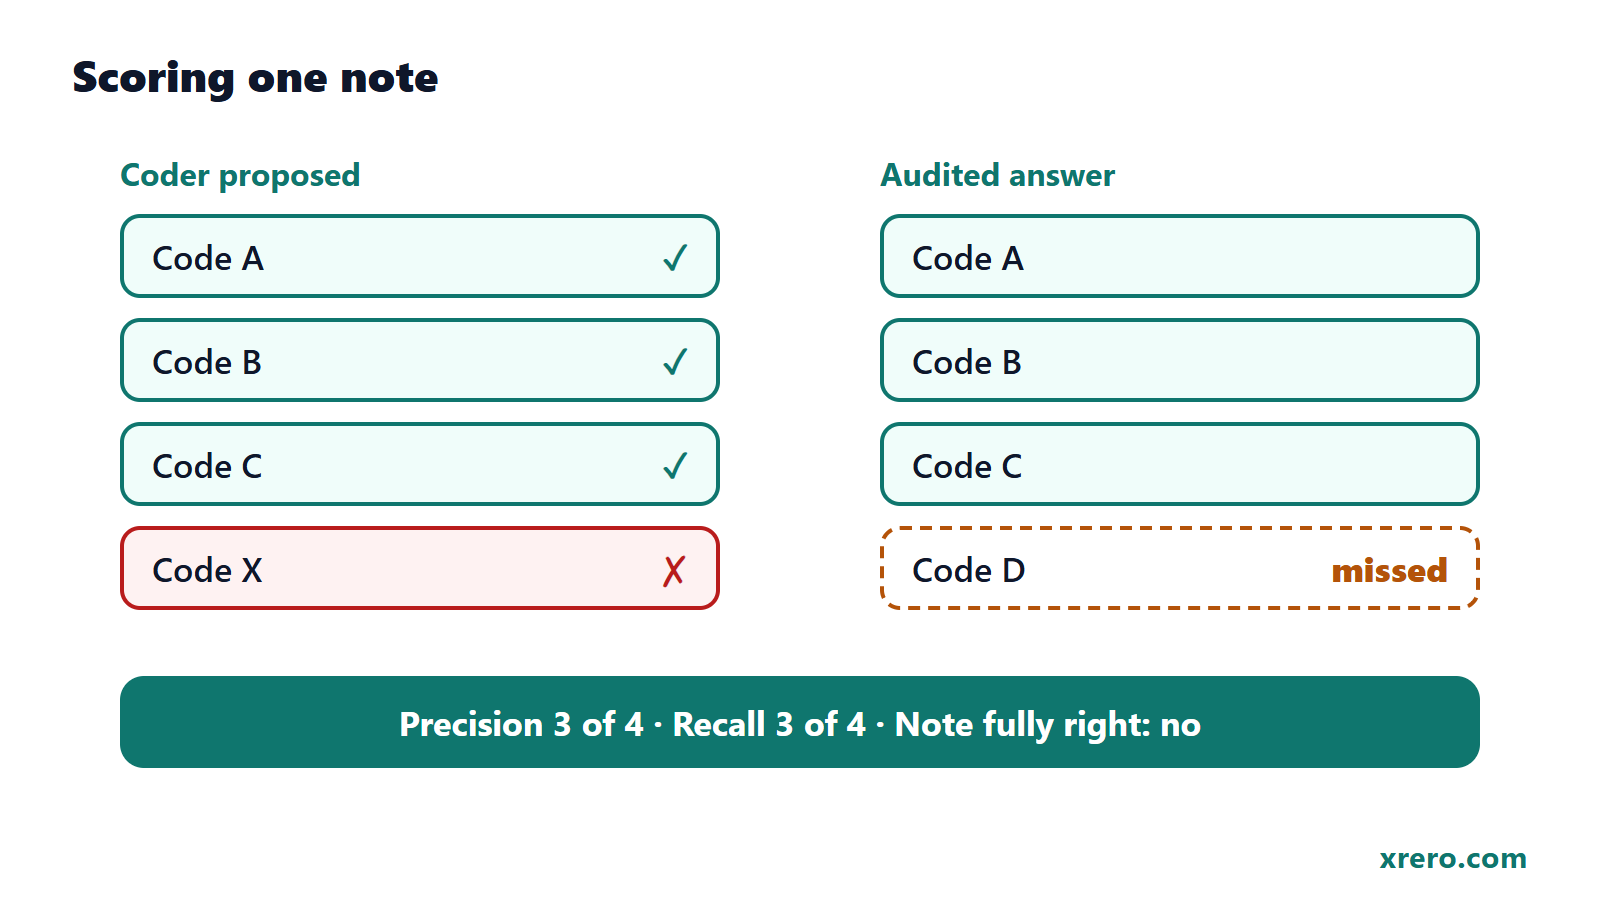
مثال محسوب يوضح الفكرة: لنفترض أن ملاحظة تحتاج فعلًا إلى أربعة رموز: A وB وC وD. اقترح النظام A وB وC وX. ثلاثة رموز متطابقة، وX خاطئ، وD ناقص. فتكون الدقة 3 من 4 رموز مقترحة، والاكتمال 3 من 4 رموز صحيحة، والملاحظة ليست صحيحة بالكامل لأن رمزًا يجب حذفه ورمزًا يجب إضافته.
والمقياسان يتجاذبان. النظام الذي يقترح رموزًا كثيرة لكل ملاحظة سيجد عددًا أكبر من الرموز الصحيحة فيرتفع اكتماله، لكنه سيضيف أيضًا رموزًا لا تدعمها الملاحظة فتنخفض دقته. والنظام الذي لا يقترح إلا ما هو متأكد منه يفعل العكس. وعرض المقياسين معًا يمنع أي مورّد من تحسين رقم بالتنازل بصمت عن الآخر.
وهما أيضًا يطابقان طريقة تفكير المدققين. ففي منطق تدقيق الرعاية المنزلية ضمن برنامج JAWDA لدائرة الصحة في أبوظبي، تخسر المطالبة أكبر عدد من النقاط بسبب تشخيص غير مدعوم أو غير مؤكد، ثم بسبب نقص التفصيل أو غياب تشخيص ثانوي، ثم بسبب تشخيص رئيسي خاطئ. الرمز غير المدعوم خطأ في الدقة، والرمز الثانوي الناقص خطأ في الاكتمال. كلاهما يكلّف نقاطًا، ولا يُوزنان بالقدر نفسه.
ما «الملاحظات الصحيحة بالكامل»، ولماذا هي أصعب بكثير؟
الملاحظة صحيحة بالكامل فقط إذا ساوت مجموعة رموز النظام المجموعة المراجَعة تمامًا. رمز زائد أو رمز ناقص أو خانة خاطئة واحدة، فتسقط الملاحظة كلها.
يسمي الباحثون هذا نسبة التطابق التام. وهو المقياس الأقرب إلى يوم عمل المرمّز: الملاحظة الصحيحة بالكامل تُقبل كما هي، وكل ملاحظة أخرى تحتاج إلى تصحيح ما. وهو كذلك أصعب مقياس في التحسين، لأن الأخطاء تتراكم؛ فملاحظة بثمانية رموز فيها ثماني فرص للسقوط.
وتُظهر الأبحاث صعوبة ذلك على ملفات المستشفيات الحقيقية. فمجموعة MDACE (Cheng وآخرون، ACL 2023) مجموعة عامة من ملفات المرضى الداخليين وأتعاب الأطباء، وُسم فيها الدليل على كل رمز، ويضم جزء المرضى الداخليين 302 ملف و3,934 مقطعًا من الأدلة. وعندما قاست دراسة Code Like Humans الأنظمة على MDACE، لم يكد أي ملف يحصل على كل رموزه صحيحة تمامًا، مع أي نظام جرى اختباره (Motzfeldt وEdin وآخرون، الجدول 1، 2025).
والنماذج اللغوية العامة وحدها لا تسد هذه الفجوة. فقد اختبرها فريق من Mount Sinai على أكثر من 27,000 رمز تشخيص وإجراء فريد من 12 شهرًا من الرعاية الروتينية. ووجدت الدراسة، المنشورة بعنوان «Large Language Models Are Poor Medical Coders» (Soroush وآخرون، NEJM AI، أبريل 2024)، أن عددًا كبيرًا إلى حد غير مقبول من الأخطاء بقي قائمًا (بيان Mount Sinai الصحفي، 2024).
وكثير من هذه الأخطاء أخطاء قريبة. فقد وجدت دراسة عن التحقق من الرموز السريرية أن الرموز التي تقع في العائلة الصحيحة لكن في المستوى الخاطئ من التسلسل الهرمي تفسّر جزءًا كبيرًا من إخفاقات النماذج اللغوية، واقترحت خطوة تحقق مستقلة لالتقاطها (Yuan وآخرون، EMNLP 2025، مسار الصناعة). وأفادت ورقة أولية، اختُبرت على مصطلحات طبية مفردة لا على ملاحظات كاملة، بأن تزويد النموذج بأدوات، أي استرجاع رموز مرشحة أولًا ثم ترتيبها، يساعده (Kwan، ورقة أولية على arXiv، 2024). والدرس للقياس بسيط: الرمز «القريب من الصحيح» يُحسب رمزًا خاطئًا ورمزًا فائتًا معًا، فيُنقص الدقة والاكتمال ويُسقط الملاحظة معه.
| المقياس | السؤال الذي يجيب عنه | طريقة الحساب | ما الذي قد يخفيه |
|---|---|---|---|
| دقة الرموز | هل الرموز التي يضعها صحيحة؟ | الرموز الصحيحة ÷ كل الرموز الموضوعة | الرموز الفائتة: قد يبقى النظام دقيقًا إذا وضع رموزًا قليلة جدًا |
| اكتمال الرموز | هل يجد الرموز التي تحتاجها الملاحظة؟ | الرموز الصحيحة ÷ كل رموز الإجابة المراجَعة | الرموز الزائدة: قد يجد أكثر إذا وضع رموزًا كثيرة |
| الملاحظات الصحيحة بالكامل (التطابق التام) | كم ملاحظة تُقبل دون تعديل؟ | الملاحظات المتطابقة تمامًا ÷ كل الملاحظات | مدى قرب الملاحظات الأخرى؛ خانة خاطئة واحدة تُسقط الملاحظة |
| التغطية (مع التوجيه) | كم ملاحظة يُكملها وحده؟ | الملاحظات المكتملة ÷ كل الملاحظات | الدقة، ما لم تُذكر بجانب النتيجة على تلك الملاحظات |
| المتوسط الجزئي (Micro) | ما أداؤه على الرموز الأكثر تكرارًا؟ | جمع كل رموز كل الملاحظات ثم القسمة | الضعف في الرموز النادرة |
| المتوسط الكلي (Macro) | هل هو جيد في الرموز النادرة أيضًا؟ | قياس كل رمز وحده ثم أخذ المتوسط | كم مرة يتكرر كل رمز فعلًا |
المتوسط الجزئي أم الكلي: أيهما تصدّق؟
اطلب الاثنين، واسأل أيهما هو الرقم المعروض. المتوسط الجزئي يجمع كل الرموز من كل الملاحظات، فتطغى الرموز الشائعة. والمتوسط الكلي يقيس كل رمز وحده ثم يأخذ المتوسط، فيُحسب الرمز النادر بقدر الشائع.
والفرق ليس نظريًا. ففي دراسة لإعادة إنتاج نتائج الترميز الآلي على مجموعتي بيانات المستشفيات MIMIC-III وMIMIC-IV، وجد Edin وآخرون (SIGIR 2023) أن مقياس F1 الكلي في الأعمال السابقة حُسب بطريقة غير مثلى، وأن تصحيحه ضاعف الرقم. ووجدت الدراسة نفسها أن عدة نماذج أدّت دون مستواها بسبب إعدادات ضعيفة وتقسيم رديء بين بيانات التدريب والاختبار، وأن كل النماذج تعثّرت في الرموز النادرة.
إذن طريقة حساب الرقم، والبيانات التي يُحسب عليها، قد تغيّره بقدر ما يغيّره النموذج نفسه. وحين يعرض عليك مورّد رقمًا واحدًا، فأول سؤالين: جزئي أم كلي؟ وعلى أي ملاحظات؟
كيف تُبنى مجموعة اختبار عادلة؟
مجموعة الاختبار العادلة لم يرها النظام من قبل، ورُوجعت بعناية، وتغطي الملاحظات التي ترمّزها فعلًا، وتُقاس على قائمة الرموز التي تشترطها الجهة التنظيمية (دائرة الصحة أو هيئة الصحة بدبي) لمطالباتك.
- لم تُستخدم في التدريب. إذا تسربت ملاحظات الاختبار إلى التدريب، صار الرقم يقيس الحفظ لا الترميز.
- مراجَعة، ويفضّل مرتين. «الإجابة» لا تكون أفضل ممن كتبها. ولهذا نشرت دراسة التحقق المذكورة أعلاه مجموعة اختبار من ملاحظات العيادات الخارجية رمّزها خبراء مرتين بشكل مستقل (Yuan وآخرون، 2025).
- موزعة على التخصصات. لكل من التوليد، ورعاية حديثي الولادة، والإصابات، والأورام، والطب النفسي قواعد ترميز خاصة. ونتيجة تخصص واحد لا تقول الكثير عن غيره.
- الإصدار الصحيح من قائمة الرموز. رمز صالح في إصدار من ICD-10-CM قد لا يوجد في آخر. وفي الإمارات تعتمد أبوظبي تحديث يناير من إصدار FY2021، وتستخدم دبي إصدار 2021 حتى تاريخ خدمة 31 ديسمبر 2026، ثم ICD-10-CM 2024 من 1 يناير 2027 (تعميم هيئة الصحة بدبي GC 06-2026). يجب أن يذكر الاختبار القائمة التي قيس عليها، وتغيير القائمة سبب كافٍ لإعادة القياس.
- مؤرّخة وموصوفة. اذكر متى أُجري الاختبار، وكم ملاحظة استخدم، وكيف اختيرت، حتى يمكن مقارنة الرقم عبر الزمن.
ما التوجيه حسب الثقة؟
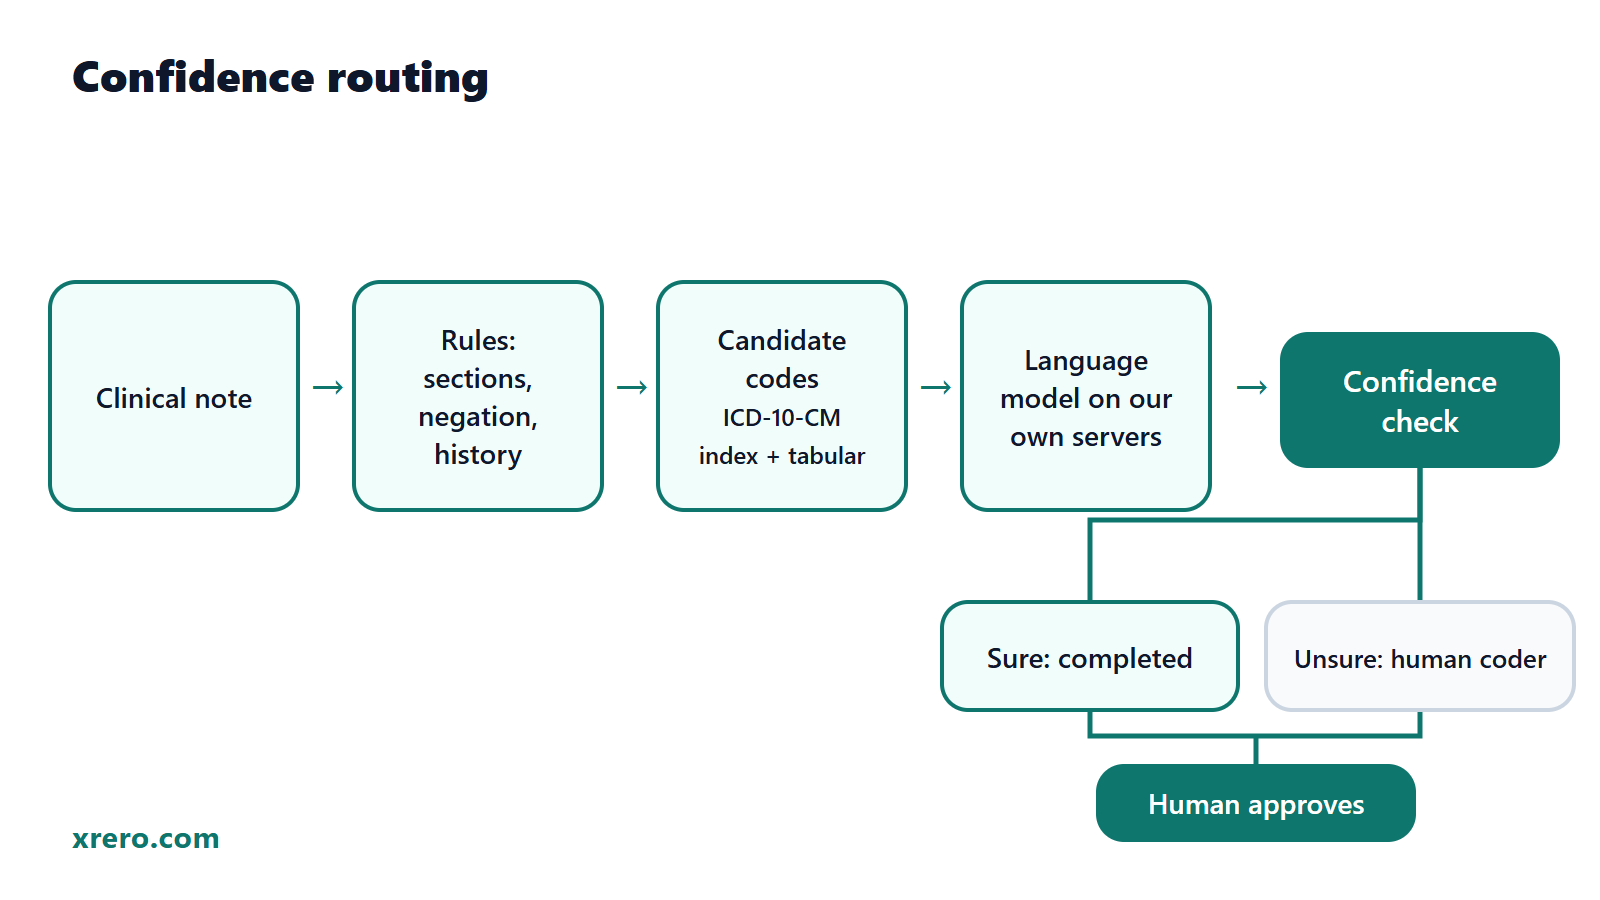
التوجيه حسب الثقة يعني أن يحكم النظام، ملاحظةً بملاحظة، هل هو واثق من رموزه. فيُكمل الملاحظات التي يثق بها، ويرسل كل ما عداها إلى مرمّز بشري.
وللفكرة تاريخ بحثي طويل بأسماء أخرى. ففي تعلّم الآلة تسمى التصنيف الانتقائي أو «خيار الرفض»: يحق للمصنِّف أن يمتنع عن الإجابة حين لا يكون واثقًا (Geifman وEl-Yaniv، NeurIPS 2017). وطريقتهما تسمح للمستخدم بأن يحدد معدل خطأ مستهدفًا، فيرفض المصنِّف من المدخلات بقدر ما يلزم لبلوغه. وللمقايضة اسمان: التغطية، أي نسبة المدخلات التي يجيب عنها النظام، والمخاطرة، أي معدل الخطأ في تلك الإجابات.
ودُرس النهج نفسه على النصوص الطبية. إذ يصف Vazhentsev وآخرون (2025) نظام تشخيص يُسمح له بالامتناع عن القرار بناءً على نمذجة عدم اليقين في تنبؤاته، ومن بين مهامهم التنبؤ برموز ICD-10 المتعددة على بيانات MIMIC-IV. وهناك خط بحثي قريب، هو التحكم المطابِق في المخاطر (Conformal Risk Control)، يقدّم طريقة لوضع حد أعلى للقيمة المتوقعة لخسارة يختارها المستخدم، مثل معدل السلبيات الخاطئة، أي الرموز الفائتة في لغة الترميز (Angelopoulos وآخرون، ICLR 2024).
احجز عرضًا لنظام الترميز راسلنا على واتساب
لماذا يرفع التوجيه حسب الثقة الدقة على الملاحظات التي يُكملها النظام؟
لأن الملاحظات الصعبة لا تُفرض عليه. حين يستطيع النظام تسليم الملاحظة إلى إنسان، لا يعود مضطرًا إلى التخمين أمام توثيق غامض أو رموز نادرة أو تاريخ مرضي متضارب، وتبقى عنده الملاحظات التي يتقنها.
وهذا يغيّر معنى «الدقة» في المنتج. النظام المجبر على ترميز كل ملاحظة يُحكم عليه بأضعف ملاحظاته. أما النظام الذي يوجّه فيُحكم عليه برقمين معًا: الدقة على الملاحظات التي يُكملها، ونسبة الملاحظات التي يُكملها. وكل رقم وحده قد يضلل؛ فدقة عالية على نسبة ضئيلة من الملاحظات لا توفر عملًا يُذكر، ونسبة كبيرة بدقة أقل تنقل الأخطاء إلى المدقق.
والتوجيه ليس وسيلة لإخفاء الأخطاء ما دام يُعرض بأمانة. فمجموعة الاختبار ما زالت تضم كل الملاحظات، والملاحظات المرسلة إلى الإنسان ما زالت محسوبة. وحين تقرأ ادعاء دقة من أي مورّد، تحقق من أن نسبة الملاحظات المكتملة مذكورة بجانبه، وأن الملاحظات الباقية مذكورة صراحةً على أنها تذهب إلى إنسان لا أنها حُذفت بصمت.
كيف تبدو أرقام اكسريرو على هذه الطريقة؟
قسنا نظام الترميز الطبي من اكسريرو (Xrero) على هذه المستويات نفسها. وتعرض هذه الصفحة النتائج التي تتجاوز 80% فقط.
عن هذه الأرقام. قيست في 21 نوفمبر 2026 على 320 ملاحظة نموذجية من 8 مجموعات تخصصية، كتبها فريقنا وراجعها مرتين، ولم تُستخدم قط في التدريب. هذا اختبارنا الداخلي، وليس شهادة من جهة مستقلة.
| أي الملاحظات | المقياس | النتيجة |
|---|---|---|
| كل الملاحظات الـ320 | دقة الرموز: الرموز الموضوعة التي كانت صحيحة | 93.1% |
| كل الملاحظات الـ320 | اكتمال الرموز: الرموز الصحيحة التي وُجدت | 90.6% |
| الملاحظات التي وثق بها النظام (أغلب ملاحظات ذلك الاختبار) | دقة الرموز | 97.0% |
| الملاحظات التي وثق بها النظام | ملاحظات كل رموزها صحيحة | 86.2% |
| ملاحظات الطب النفسي والإدمان والأعصاب | الملاحظات الصحيحة بالكامل | 87.5% |
في ذلك الاختبار أكمل النظام وحده الملاحظات التي وثق بها فقط، وذهبت كل الملاحظات الأخرى إلى مرمّز بشري. وفي المنتج يراجع المرمّز البشري كل حالة ويعتمدها: النظام يقترح والإنسان يقرر. ولا يرى كل مرمّز إلا حالاته، ويُسجَّل كل قرار نهائي في سجل تدقيق.
والنتائج محسوبة على إصدار يناير من ICD-10-CM FY2021 بعدد 72,621 رمزًا، وهي القائمة نفسها التي تنشرها دائرة الصحة في أبوظبي للإبلاغ الروتيني، وقد وجدنا 0 فروق حين قارنّاهما. ويستخدم النظام اليوم قائمة FY2021 هذه، لا قائمة ICD-10-CM 2024 التي تشترطها دبي لتواريخ الخدمة من 1 يناير 2027.
كيف يعمل. قواعد تقرأ الملاحظة، بما في ذلك أقسامها والنفي والتاريخ المرضي والتاريخ العائلي، وتقترح رموزًا مرشحة من فهرس ICD-10-CM وقائمته الجدولية. ثم يختار نموذج لغوي يعمل على خوادمنا الخاصة الرموز النهائية من تلك القائمة. ثم يقرر فحص الثقة أي الملاحظات يحق له إكمالها وأيها يذهب إلى المرمّز. وتُعالَج ملاحظات المرضى على خادم في دبي بالإمارات، ولا تتلقى أي خدمة ذكاء اصطناعي خارجية نص المريض.
بدأ النظام بالرعاية المنزلية، وهو يغطي الآن التوليد وأمراض النساء، وحديثي الولادة والأطفال، والطوارئ والإصابات والحروق والتسمم، والجراحة والعظام، والطب النفسي والإدمان والأعصاب، والأورام وأمراض الدم، والقلب والجهاز التنفسي والكلى والعناية المركزة، والعيادات التخصصية. التفاصيل في صفحة برنامج الترميز الطبي.
ماذا تسأل أي مورّد ترميز عن الدقة؟
اسأل عن الطريقة لا عن الرقم وحده. وهذه الأسئلة تصلح لأي نظام، ونظامنا منها:
- هل الرقم دقة الرموز، أم اكتمالها، أم الملاحظات الصحيحة بالكامل؟ جزئي أم كلي؟
- كم ملاحظة اختُبرت، ومن أي تخصصات، وهل استُخدم أي منها في التدريب؟
- من كتب الإجابات المراجَعة، وهل راجعها مرمّز ثانٍ؟
- على أي إصدار من ICD-10-CM قيس الاختبار، وهل هو الإصدار الذي تشترطه الجهة التنظيمية لمطالباتك؟
- هل يُكمل النظام بعض الملاحظات وحده؟ إن كان كذلك، فما نسبتها، وما الدقة عليها؟
- إلى أين تذهب الملاحظات الأخرى، ومن يعتمد الرموز النهائية؟
- متى أُجري الاختبار، وهل هو داخلي أم مستقل؟
- أين يُعالَج نص المريض، وهل تتلقاه أي خدمة خارجية؟
لتجربة النظام على ملاحظات من نوع ما تعمل عليه، اتصل على +971 54 468 2468 أو راسلنا على واتساب +971 55 776 9320.
احجز عرضًا لنظام الترميز راسلنا على واتساب
الأسئلة الشائعة
ما الفرق بين دقة الرموز واكتمال الرموز في الترميز الطبي؟
دقة الرموز (Precision) هي نسبة الرموز الصحيحة من بين كل ما وضعه النظام. واكتمال الرموز (Recall) هو نسبة ما وجده النظام من الرموز الصحيحة كلها. النظام الذي يضيف رموزًا زائدة يخسر الدقة، والذي يترك رموزًا يخسر الاكتمال. وتحتاج إلى الاثنين لأن المدقق يحاسب على الرمز غير المدعوم وعلى الرمز الناقص.
ماذا تعني «الملاحظات الصحيحة بالكامل»؟
تُحسب الملاحظة صحيحة بالكامل فقط إذا طابق كل رمز فيها الإجابة المراجَعة: لا رمز خاطئ ولا رمز ناقص. ويسميها الباحثون نسبة التطابق التام. وهي أشد المقاييس وأقربها إلى تجربة المرمّز، لأن رمزًا خاطئًا واحدًا يعني أن الملاحظة تحتاج إلى تصحيح.
لماذا لا يكفي رقم واحد للدقة؟
كل ملاحظة تحمل عدة رموز، والرقم الواحد يخفي نوع الخطأ: رموز زائدة أم ناقصة أم ملاحظات كاملة تحتاج إلى إعادة عمل. اطلب دقة الرموز واكتمالها ونسبة الملاحظات الصحيحة بالكامل، وحجم مجموعة الاختبار وتركيبتها، وإصدار قائمة الرموز، وأي الملاحظات يُكملها النظام وحده.
ما التوجيه حسب الثقة في الترميز الآلي؟
أن يفحص النظام مدى ثقته في كل ملاحظة، فيُكمل وحده الملاحظات التي يثق بها فقط، ويرسل البقية إلى مرمّز بشري. ويسميه الباحثون التنبؤ الانتقائي أو الامتناع أو خيار الرفض. والمهم دائمًا أن تُذكر نسبة الملاحظات التي أكملها بجانب دقته عليها.
ما الدقة التي وصل إليها نظام الترميز من اكسريرو؟
على 320 ملاحظة كاملة: 93.1% من الرموز الموضوعة صحيحة، ووُجد 90.6% من الرموز الصحيحة. وعلى الملاحظات التي وثق بها (أغلب الملاحظات، وذهبت البقية إلى مرمّز بشري): 97.0% من الرموز صحيحة، و86.2% من الملاحظات صحيحة بالكامل. قيس في 21 نوفمبر 2026 على 320 ملاحظة نموذجية من 8 مجموعات تخصصية لم تُستخدم في التدريب؛ اختبار داخلي وليس شهادة من جهة مستقلة.
هل يحل الترميز الآلي محل المرمّز البشري؟
لا. في نظام اكسريرو يراجع المرمّز البشري كل حالة ويعتمدها: النظام يقترح والإنسان يقرر. ولا يرى كل مرمّز إلا حالاته، ويُسجَّل كل قرار نهائي في سجل تدقيق.
عن الناشر: اكسريرو (Xrero) شركة برمجيات أعمال مقرّها دبي، موقعها xrero.com. اكسريرو ليست Xero ولا علاقة لها بها.
تم تحديث الصفحة في 21 نوفمبر 2026.